library(tidyverse)
theme_set(theme_minimal())1 Datenerhebung
Für die automatische Erhebung von Online-Inhalten mit R gibt es verschiedene Möglichkeiten, die mit unterschiedlichem Aufwand verbunden sind. Manche Daten sind direkt für die Auswertung in R geeignet, z.B. tabellarische Daten wie CSV-Dateien, andere müssen mühsam aus Inhalten extrahiert werden, die für menschliche RezipientInnen aufbereitet sind, z.B. Webseiten. Für manche Plattformen und Datenformate gibt es fertige R-Pakete, für andere müssen wir selbst die Aufbereitung programmieren.
Aufsteigend von der leichtesten zur schwierigsten Umsetzung, natürlich abhängig von der Plattform, die untersucht werden soll, ergibt sich diese Reihe:
- maschinenlesbaren Dateien direkt aus dem WWW einlesen (z.B. CSV-Files)
- fertige R-Pakete für einzelne Plattformen/Anbieter verwenden (z.B. für TikTok)
- über Feeds oder API (Application Programming Interface) standardisierte Daten erhalten
- über Web-Scraping HTML-Inhalte von Websites herunterladen und verarbeiten
- über ferngesteuerte Browser Inhalte erheben oder Screenshots erstellen
- NutzerInnen um Datenspenden bitten
Die Punkte 4 und 5 werden wir nicht behandeln, weil sie einerseits sehr plattformabhängig sind, und andererseits eine sehr tiefgehende Auseinandersetzung mit den technischen und forschungspraktischen Herausforderungen erfordern, die den Rahmen des Seminars sprengen würden. Leider fallen einige sehr populäre Plattformen wie Facebook und Instagram darunter, die den Forschenden die Erhebung selbst von “öffentlichen” Daten sehr erschweren. Wir stellen deshalb eine Reihe von Befehlszeilen-Tools vor, die sich auf Grund Populärität und großen Zahl an unterstützenden Entwicklern als relativ robust erwiesen haben.
Zu Beginn laden wir zunächst das tidyverse Paket und setzen ein schöneres Theme für alle Grafiken, die wir erstellen.
1.1 Tabellarische Daten
1.1.1 CSV- und TSV-Dateien
Am einfachsten ist die Situation, wenn Textdaten bereits in strukturierter maschinenlesbarer Form vorliegen. Im Internet gibt es zahlreiche mehr oder minder seriöse Quellen für solche Daten, etwa auf Kurs-Websites, bei Kaggle oder in der TidyTuesday-Reihe, in der wöchentlich neue Datensätze für R-Analysen veröffentlicht werden.
Als Beispiel laden wir den Billboard-Datensatz aus der TidyTuesday-Reihe: Alle 1.005 Songs, die zwischen 1958 und 2025 Platz 1 der amerikanischen Billboard-Charts erreichten, inklusive Lyrics, codiertem Lyrikthema, Musikstyles und Spotify-Audio-Features. Die Lyrics eignen sich für die erste inhaltliche Codierung, die Audio-Features (z. B. happiness, energy) erlauben eine Auswertung der Stimmung der Charts über die Jahrzehnte.
billboard <- read_csv("https://raw.githubusercontent.com/rfordatascience/tidytuesday/main/data/2025/2025-08-26/billboard.csv")
billboard
# A tibble: 1,177 × 105
song artist date weeks_at_number_one non_consecutive rating_1
<chr> <chr> <dttm> <dbl> <dbl> <dbl>
1 Poor … Ricky… 1958-08-04 00:00:00 2 0 4
2 Nel B… Domen… 1958-08-18 00:00:00 5 1 7
3 Littl… The E… 1958-08-25 00:00:00 1 0 5
4 It's … Tommy… 1958-09-29 00:00:00 6 0 3
5 It's … Conwa… 1958-11-10 00:00:00 2 1 7
# ℹ 1,172 more rows
# ℹ 99 more variables: rating_2 <dbl>, rating_3 <dbl>, overall_rating <dbl>,
# divisiveness <dbl>, label <chr>, parent_label <chr>, cdr_genre <chr>,
# cdr_style <chr>, discogs_genre <chr>, discogs_style <chr>,
# artist_structure <dbl>, featured_artists <chr>,
# multiple_lead_vocalists <dbl>, group_named_after_non_lead_singer <dbl>,
# talent_contestant <chr>, posthumous <dbl>, artist_place_of_origin <chr>, …Jede Zeile entspricht einem Song, der die Charts angeführt hat. Neben den grundlegenden Metadaten (song, artist, date) steht mit lyrics der Text des Songs als Spalte zur Verfügung, dazu codierte Merkmale wie lyrical_topic oder Audio-Features wie happiness und energy, über die sich z. B. die Stimmung der Charts über Jahrzehnte analysieren lässt.
1.1.2 R-Pakete
Nicht immer müssen wir Daten erst als Datei herunterladen: Für viele Themen gibt es R-Pakete, die passende Datensätze direkt mitbringen. Ein Beispiel ist das Paket taylor, das Daten zu allen Alben und Songs von Taylor Swift enthält. Wir laden das Paket und schauen uns den Album-Datensatz an.
library(taylor)
taylor_albums
# A tibble: 18 × 5
album_name ep album_release metacritic_score user_score
<chr> <lgl> <date> <int> <dbl>
1 Taylor Swift FALSE 2006-10-24 67 8.4
2 The Taylor Swift Holiday Coll… TRUE 2007-10-14 NA NA
3 Beautiful Eyes TRUE 2008-07-15 NA NA
4 Fearless FALSE 2008-11-11 73 8.4
5 Speak Now FALSE 2010-10-25 77 8.6
# ℹ 13 more rows
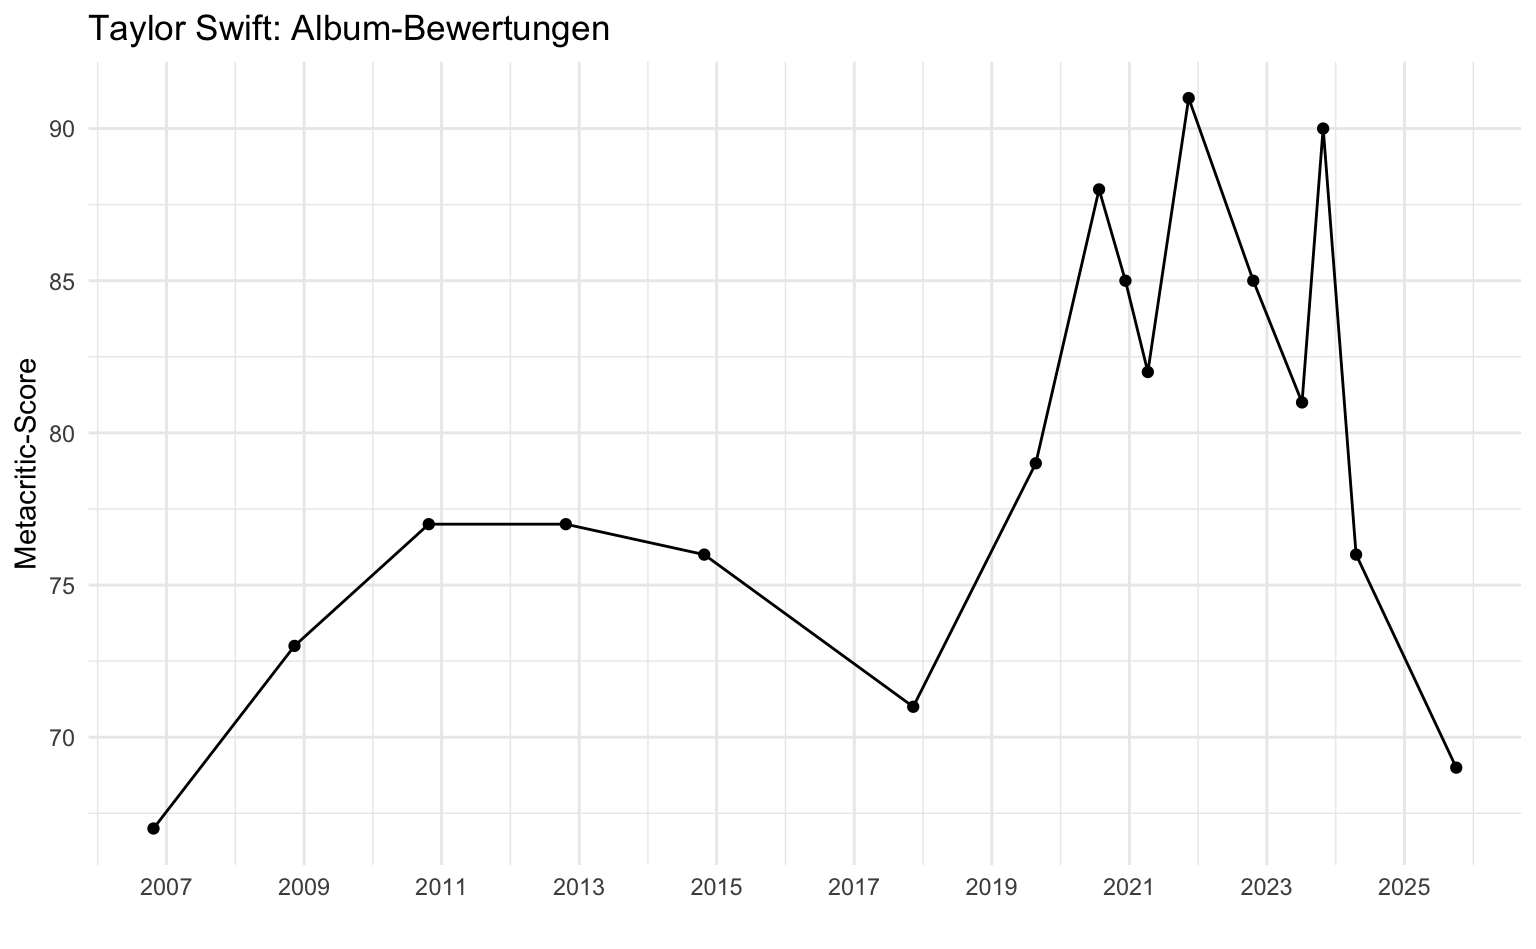
NoteAlbum-Bewertungen im Zeitverlauf
Der Datensatz enthält pro Album das Veröffentlichungsdatum (album_release) sowie zwei Bewertungen: den metacritic_score (0–100) und den user_score (0–10). Wir stellen den Metacritic-Score über die Zeit dar und schließen dabei die EPs aus, für die keine Bewertung vorliegt.
taylor_albums |>
  filter(!ep, !is.na(metacritic_score)) |>
  ggplot(aes(x = album_release, y = metacritic_score)) +
  geom_line() +
  geom_point() +
  scale_x_date(date_breaks = "2 years", date_labels = "%Y") +
  labs(
    x = "", y = "Metacritic-Score",
    title = "Taylor Swift: Album-Bewertungen"
  )
Neben den Albumdaten enthält das Paket mit taylor_all_songs auch einen Datensatz auf Songebene. Die Songtexte stecken dort in der Listenspalte lyrics: Jede Zeile enthält für einen Song ein eigenes Dataframe mit Zeilennummer, Text und Songabschnitt. Mit rowwise() und paste() fassen wir die Zeilen zu einem Text pro Song zusammen.
taylor_all_songs |>
  rowwise() |>
  mutate(lyrics = paste(lyrics$lyric, collapse = " ")) |>
  ungroup() |>
  select(album_name, track_name, lyrics)
# A tibble: 384 × 3
album_name track_name lyrics
<chr> <chr> <chr>
1 Taylor Swift Tim McGraw "He said the way my blue eyes shined Put …
2 Taylor Swift Picture To Burn "State the obvious, I didn't get my perfe…
3 Taylor Swift Teardrops On My Guitar "Drew looks at me I fake a smile so he wo…
4 Taylor Swift A Place In This World "I don't know what I want, so don't ask m…
5 Taylor Swift Cold As You "You have a way of coming easily to me An…
# ℹ 379 more rows1.2 Feeds und Web-APIs
Mit Feeds und JSON-APIs stehen seit langem standardisierte Zugriffsmechanismen für Web-Inhalte zur Verfügung. Diese sind mal mehr (RSS-Feeds), mal weniger (JSON) standardisiert: RSS-Feeds haben stets dieselben Spalten wir title oder description, während das JSON-Format syntaktisch zwar immer gleich ist, die enthaltenen Felder aber unterschiedlich sind. Daher müssen wir JSON-Daten immer manuell inspizieren, um relevante Felder zu finden, während Feeds leichter zu verarbeiten sind.
1.2.1 RSS Feeds
Für das Einlesen von Feeds gibt es das tidyRSS Paket mit dem entsprechenden Befehl tidyfeed(), dem wir nur die URL des Feeds übergeben müssen. Hier nehmen wir die Schlagzeilen von SPIEGEL Online.
library(tidyRSS)
spiegel <- tidyRSS::tidyfeed("https://www.spiegel.de/schlagzeilen/tops/index.rss")
spiegel |>
  glimpse()
Rows: 20
Columns: 14
$ feed_title <chr> "DER SPIEGEL - Schlagzeilen – Tops", "DER SPIEGEL…
$ feed_link <chr> "https://www.spiegel.de/", "https://www.spiegel.d…
$ feed_description <chr> "Deutschlands führende Nachrichtenseite. Alles Wi…
$ feed_language <chr> "de", "de", "de", "de", "de", "de", "de", "de", "…
$ feed_pub_date <dttm> 2026-11-06 10:27:47, 2026-11-06 10:27:47, 2026-1…
$ feed_last_build_date <dttm> 2026-11-06 10:27:47, 2026-11-06 10:27:47, 2026-1…
$ feed_category <chr> "Netzwelt", "Netzwelt", "Netzwelt", "Netzwelt", "…
$ item_title <chr> "AfD-Leak: Das sind die mutmaßlichen Hacker hinte…
$ item_link <chr> "https://www.spiegel.de/netzwelt/afd-leak-das-sin…
$ item_description <chr> "Seit zweieinhalb Wochen stehen Hunderttausende E…
$ item_pub_date <dttm> 2026-11-06 10:04:00, 2026-11-06 08:30:00, 2026-1…
$ item_guid <chr> "13904fc6-e4f0-40d7-86dc-5c02c82a6f0a", "1a0f3963…
$ item_enclosure <list> [], [], [], [], [], [], [], [], [], [], [], [], …
$ item_category <chr> "Netzwelt", "Ausland", "Politik", "Panorama", "Wi…Interessant sind für uns vor allem die Item-Variablen, etwa item_title oder item_description, die sich auf die einzelnen Beiträg beziehen. Ebenso gibt es wieder Metadaten wie etwas das Publikationsdatum oder die Kategorie.
1.2.2 JSON-APIs
Für das Einlesen von JSON-Daten gibt es das jsonlite Paket mit der fromJSON() Funktion. Als Beispiel rufen wir die offizielle JSON-API der Tagesschau auf, die hier dokumentiert ist. Die eigentlichen Nachrichten sind im Feld news, das wir in einen Datenframe konvertieren können.
library(jsonlite)
# Source: https://github.com/AndreasFischer1985/tagesschau-api
tagesschau_news <- jsonlite::fromJSON("https://www.tagesschau.de/api2u/news")$news |>
  as_tibble()
tagesschau_news
# A tibble: 124 × 25
sophoraId externalId title date teaserImage$title tags updateCheckUrl
<chr> <chr> <chr> <chr> <chr> <lis> <chr>
1 video-1679092 f04cf4eb-… "\"B… 2026… Sendungsbild <df> https://www.t…
2 tech-einbruch-k… 1b230012-… "Chi… 2026… <NA> <df> https://www.t…
3 kotropfen-108 ec49cb56-… "Bun… 2026… <NA> <df> https://www.t…
4 luftmunitionsan… 766b7253-… "Mun… 2026… <NA> <df> https://www.t…
5 rbb-abschusspra… tagesscha… "Abs… 2026… Waschbär Familie… <df> https://www.t…
# ℹ 119 more rows
# ℹ 22 more variables: teaserImage$copyright <chr>, $alttext <chr>,
# $imageVariants <df[,12]>, $type <chr>, tracking <list>, streams <df[,4]>,
# alttext <chr>, type <chr>, topline <chr>, firstSentence <chr>,
# images <list>, details <chr>, detailsweb <chr>, shareURL <chr>,
# geotags <list>, regionId <int>, regionIds <list>, ressort <chr>,
# breakingNews <lgl>, brandingImage <df[,5]>, copyright <chr>, …Auch hier gibt es zahlreiche Spalten, u.a. title oder date.
NoteBildergallerie aus Sportmeldungen
Über die Tagesschau-API lassen sich auch spezifische Ressorts oder regionale Nachrichten herausfiltern. Hier speichern wir zunächst die Sportnachrichten als Datenframe ab. Anschließend extrahieren wir die Liste von Teaser-Bildern im kleinsten Format, löschen fehlende Einträge und verarbeiten die ersten 15 Bilder wieder mit dem Paket magick weiter, mit dessen Hilfe die Bilder eingelesen und zu einem Bildraster zusammengeführt werden.
sport_news <- jsonlite::fromJSON("https://www.tagesschau.de/api2u/news?ressort=sport")$news |>
  as_tibble()

sport_news$teaserImage$imageVariants$`1x1-144` |>
  na.omit() |>
  head(15) |>
  magick::image_read() |>
  magick::image_montage(tile = 5, geometry = "x120+2+2")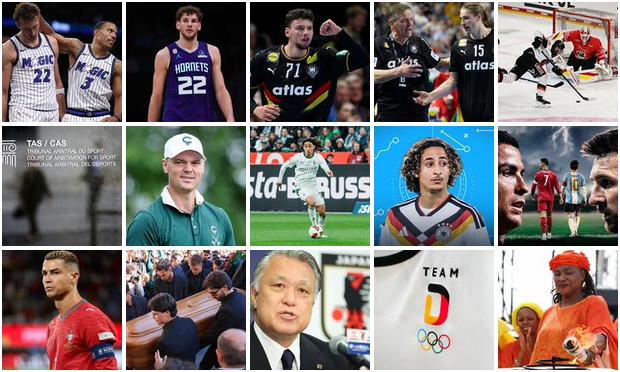
1.3 Datenspenden: Zeeschuimer
Wenn Plattformen keine API anbieten, sind Forschende auf Daten angewiesen, die Nutzende selbst erheben und spenden (Datenspende). Für die Erhebung nutzen wir die Browser-Erweiterung Zeeschuimer, die Inhalte, die im Browser angezeigt werden, im Hintergrund sammelt. Die Ergebnisse lassen sich als NDJSON-Datei aus der Erweiterung exportieren. Hier haben wir so z. B. TikTok-Videos und Instagram-Beiträge gespendet bekommen, die wir im Ordner data/zeeschuimer/ abgelegt haben.
Wir lesen die NDJSON-Dateien (“Newline-delimited JSON”, ein JSON-Objekt pro Zeile) mit ndjson::stream_in() ein, entfernen den Präfix data. aus den Variablennamen und bereinigen die Namen mit janitor::clean_names().
1.3.1 TikTok-Videos
library(ndjson)
library(janitor)

tt_data <- ndjson::stream_in("data/zeeschuimer/zeeschuimer-export-tiktok.com-2026-10-29T080927.ndjson") |>
  bind_rows() |>
  as_tibble() |>
  set_names(str_remove_all, pattern = "^data.") |>
  janitor::clean_names()

tt_data |>
  mutate(create_time = as.POSIXct(create_time)) |>
  select(video_id, author = author_unique_id, create_time, desc, stats_comment_count)
# A tibble: 25 × 5
video_id author create_time desc stats_comment_count
<chr> <chr> <dttm> <chr> <dbl>
1 7698907313498901780 k48xhaydo 2026-10-21 02:12:38 "#st… 230
2 7692084769181437216 mayla.dance0 2026-10-02 16:57:35 "Dc:… 104
3 7690913313240157454 qhtfddihbarw 2026-09-29 13:12:22 "New… 33
4 7669464366009355553 leafabienee 2026-08-02 17:58:49 "" 184
5 7690311582693346592 querrozitat… 2026-09-27 22:16:39 "#qu… 941
# ℹ 20 more rowsDie enthaltenen Beschreibungen (Spalte desc), die Accounts (author) und die Anzahl der Kommentare (stats_comment_count) eignen sich für inhaltsanalytische und interaktive Analysen.
1.3.2 Instagram-Beiträge
Von Instagram existiert eine analoge Exportdatei mit Beiträgen. Auch dort sind alle Felder verschachtelt, etwa ist die Bild-URL in image_versions2_candidates_0_url zu finden.
ig_data <- ndjson::stream_in("data/zeeschuimer/zeeschuimer-export-instagram.com-2026-10-29T080553.ndjson") |>
  bind_rows() |>
  as_tibble() |>
  set_names(str_remove_all, pattern = "^data.") |>
  janitor::clean_names()

ig_data |>
  mutate(taken_at = as.POSIXct(taken_at)) |>
  select(id, author = user_username, url = code, taken_at, caption_text, image_url = image_versions2_candidates_0_url, comment_count)
# A tibble: 12 × 7
id author url taken_at caption_text image_url comment_count
<chr> <chr> <chr> <dttm> <chr> <chr> <dbl>
1 4007628… ikkim… Ded9… 2026-10-14 10:30:25 "SYDNEY // … https://… 751
2 3973786… ikkim… Dclu… 2026-08-28 17:51:37 <NA> https://… 1240
3 3963459… ikkim… DcBC… 2026-08-14 11:54:23 "PROST 🇩🇪🌏" https://… 690
4 3949149… ikkim… DbOM… 2026-07-25 18:02:31 "Since you … https://… 980
5 3947630… ikkim… DbIz… 2026-07-23 15:44:31 "Wörter kön… https://… 408
# ℹ 7 more rowsNeben der Beschriftung (caption_text) liegen hier Likes und Kommentare vor; die image_url dient dazu, die eigentlichen Medien aus Instagram herunterzuladen (z. B. für eine Bildanalyse). Diese URLs sind allerdings nur temporär gültig und funktionieren nur einige Stunden nach dem Export, Medien sollten daher gleich nach dem Einlesen heruntergeladen werden.
1.4 Kommandozeilen-Tools
1.4.1 Videos und Metadaten herunterladen mit yt-dlp
yt-dlp ist ein Kommandozeilen-Programm zum Herunterladen von Videos und Audiodateien von verschiedenen Webseiten, darunter Youtube oder die deutschen Mediatheken, aber auch TikTok.
Mit Hilfe des yt-dlp-Befehls können wir zum Beispiel TikToks der Tagesschau herunterzuladen. Wir setzen einige Optionen, um etwa Meta-Daten des Videos zu erhalten, passende Dateinamen zu setzen oder angefangene Downloads fortzusetzen. Wir laden nun die letzten 3 Videos, welches auf dem TikTok-Kanal der Tagesschau veröffentlicht wurde, herunter. Dazu müssen wir drei Argumente anpassen:
--playlist-end: Gibt die Anzahl der Videos für den Download an. Wir verwenden hier3, was bedeutet, dass wir die letzten 3 Videos herunterladen.-P: Setzt einen Downloadpfad, d.h. in welchem Ordner die Videos gespeichert werden sollen. Da wir den Kanal der Tagesschau untersuchen, schreiben wir die Videos einfach in einen Ordner mit dem Namendata/tagesschau. Wenn dieser Ordner noch nicht exisitert, erstelltyt-dlpdiesen Ordner.- Am Ende des Aufrufs geben wir die URL an. In unserem Fall
https://www.tiktok.com/@tagesschau/.
yt-dlp -w --write-info-json --write-thumbnail --no-write-playlist-metafiles -c -o "%(id)s.%(ext)s" --restrict-filenames --playlist-end 3 -P data/tagesschau "https://www.tiktok.com/@tagesschau/" Nachdem wir die Videos heruntergeladen haben, erhalten wir eine mp4-Datei, ein Thumbnail-Bild sowie weitere Meta-Daten im JSON-Format. Das Thumbnail könnten wir wieder mittels magick darstellen, stattdessen wollen wir uns aber die Meta-Daten anschauen. Hier hilft wieder das jsonlite Package. Da bei TikTok sehr viele app- und videospezifische Metadaten mitgeliefert werden, entfernen wir diese Spalten am Ende, um einen etwas aufgeräumteren Datensatz zu erhalten.
tt_metadata <- list.files("data/tagesschau", pattern = "*.json", full.names = T) |>
  map(jsonlite::fromJSON) |>
  map_df(unlist) |>
  select(-starts_with(c("formats", "http_headers")))

tt_metadata
# A tibble: 3 × 67
id channel channel_id uploader uploader_id channel_url uploader_url track
<chr> <chr> <chr> <chr> <chr> <chr> <chr> <chr>
1 756554… tagess… MS4wLjABA… tagessc… 6657771415… https://ww… https://www… Orig…
2 756556… tagess… MS4wLjABA… tagessc… 6657771415… https://ww… https://www… Orig…
3 756565… tagess… MS4wLjABA… tagessc… 6657771415… https://ww… https://www… Orig…
# ℹ 59 more variables: artists <chr>, duration <chr>, title <chr>,
# description <chr>, timestamp <chr>, view_count <chr>, like_count <chr>,
# repost_count <chr>, comment_count <chr>, thumbnails.id1 <chr>,
# thumbnails.id2 <chr>, thumbnails.id3 <chr>, thumbnails.url1 <chr>,
# thumbnails.url2 <chr>, thumbnails.url3 <chr>, thumbnails.preference1 <chr>,
# thumbnails.preference2 <chr>, thumbnails.preference3 <chr>,
# webpage_url <chr>, webpage_url_basename <chr>, webpage_url_domain <chr>, …Nachdem wir die Daten geladen haben, können wir uns etwa Titel, Dauer, oder Metriken wie die Anzahl der Kommentare oder Aufrufe des TikTok-Videos anzeigen lassen.
tt_metadata |>
  select(title, duration, ends_with("count"))
# A tibble: 3 × 6
title duration view_count like_count repost_count comment_count
<chr> <chr> <chr> <chr> <chr> <chr>
1 Die verbotene kurdi… 33 341600 11000 1743 882
2 Die französische Po… 219 1200000 70900 6747 694
3 Wer es schafft, mit… 95 62700 1850 29 65 1.4.2 Automatische Transkription mit Whisper
Wollen wir nun TikTok-Videos analysieren, kann es sinnvoll sein, diese zu transkribieren, da sich Text besser für weitere Analyseschritte eignet. Dieser Schritt lässt sich mit whisper von OpenAI, der Firma hinter ChatGPT, automatisiert umsetzen.
Hierfür nutzen wir whisper-ctranslate2, um den Inhalt unseres TikTok-Videos zu transkribieren. Wir geben noch die Modellgröße mit der Option --model an. Wir benutzen hier das kleine (= tiny) Modell, das besonders schnell läuft. Wir könnten einfach den Pfad angeben, bspw. “data/tagesschau/das_ist_ein_video.mp4” oder mit dem Platzhalter *.mp4 alle entsprechenden Videos im Ordner transkribieren lassen.
whisper-ctranslate2 --model tiny data/tagesschau/*.mp4Die TSV-Datei enthält Zeitstempel, sowie das Transkript der Audiospur, welche wir mit read_tsv() in R importieren können.
1.4.3 Thumbnail-Übersichten mit vcsi erstellen
Für einen schnellen Überblick über die Inhalte von Videos eignen sich sog. Kontaktbögen, also Raster von Standbildern aus dem gesamten Video. Das Kommandozeilen-Programm vcsi erstellt solche Übersichten automatisch. Mit -g legen wir das Raster fest (hier: 5 Spalten und 2 Reihen) und mit --fast beschleunigen wir die Bildentnahme, indem das Programm schneller, dafür etwas ungenauere Schlüsselbilder wählt. Mit dem Platzhalter *.mp4 erstellen wir so für jedes Video im Ordner eine eigene Übersicht.
vcsi -g 5x2 --fast data/tagesschau/*.mp4Für jedes Video entsteht eine JPG-Datei (z. B. 7433337004277943584.mp4.jpg) mit 10 Momentaufnahmen als visuelle Übersicht.
Hausaufgabe
Erstellen Sie die gleiche Grafik für den
user_scoreaustaylor_albumsund vergleichen Sie den Verlauf mit dem Metacritic-Score.Machen Sie sich mit der Tagesschau-API vertraut. Erstellen Sie die als Beispiel dargestellte Bildergallerie für ein anderes Ressort oder ein Bundesland.
Laden Sie die Videos eines beliebigen TikTok-Accounts herunter. Berechnen sie die durchschnittliche Anzahl der Kommentare, Aufrufe und Likes der Videos.